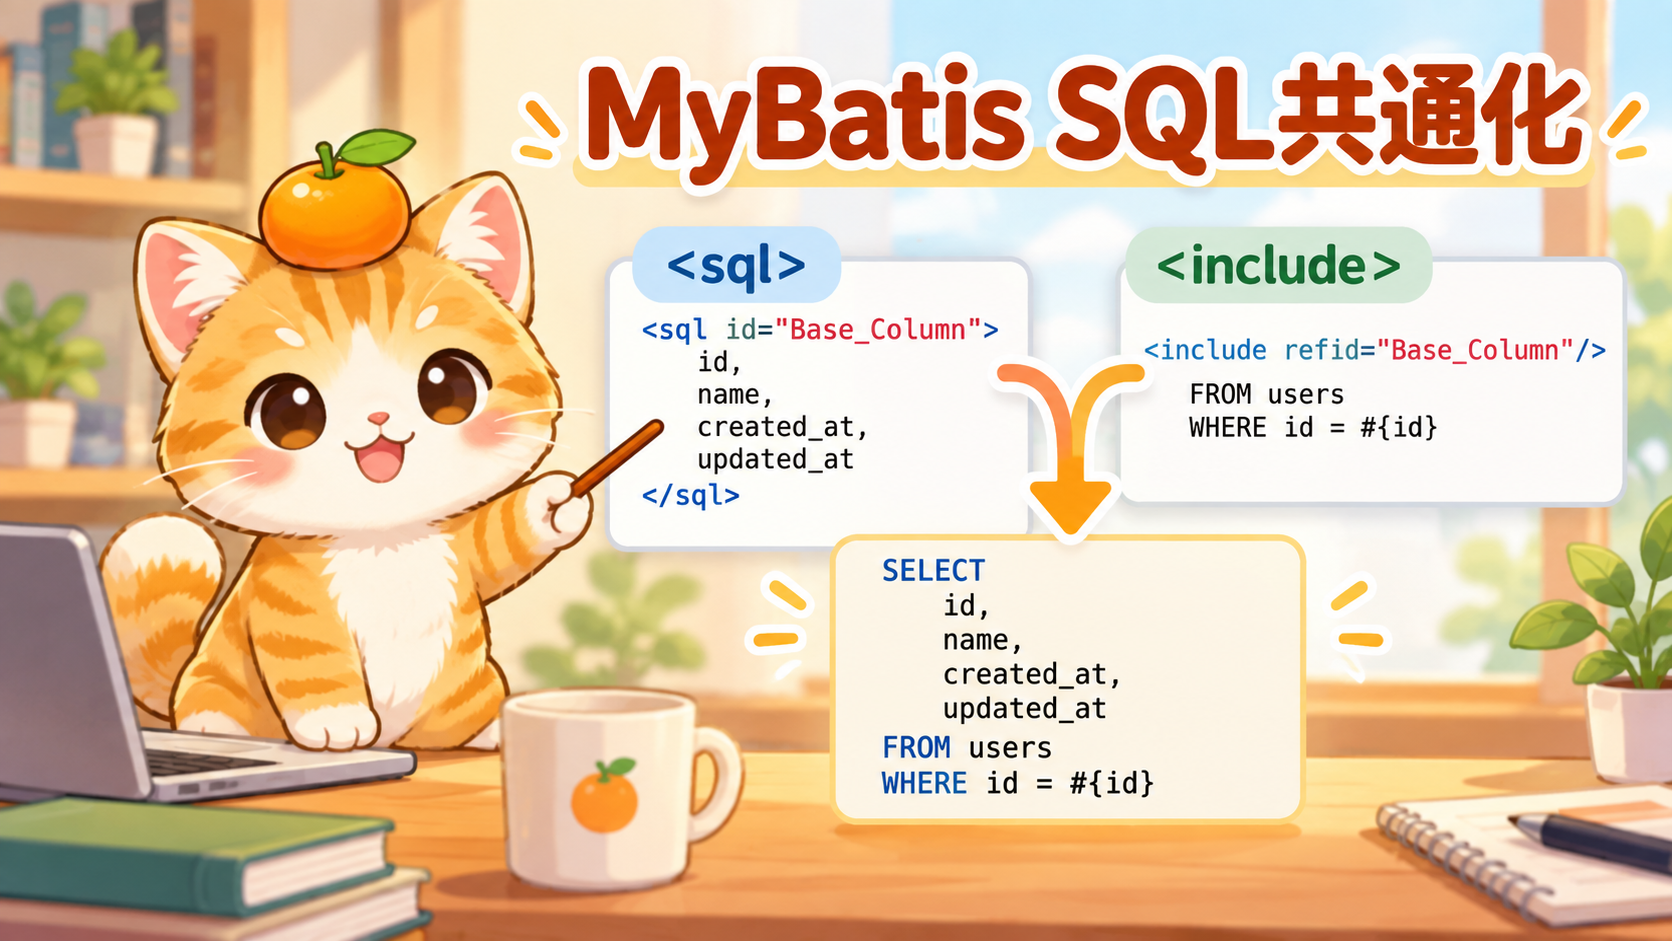
複数のSELECTに同じ列リストや検索条件を書いていると、変更のたびに同じ箇所を探して修正する必要があります。MyBatisのMapper XMLでは、<sql> でSQL断片を定義し、<include> で参照すると、こうした重複をまとめられます。
この記事では、列リストと構造が固定された条件片を例に、定義・参照の書き方と共通化の判断基準を説明します。あわせて、include propertyによるロード時の展開と、実行時に #{} で値を渡す処理を区別します。
namespaceやMapperメソッドとXMLの対応を先に確認したい場合は、Mapper XMLの基本記事を参照してください。
以下のコードは、MyBatisの導入とMapperの登録が済んでいる前提で、XML宣言やDOCTYPEなどは省略しています。
MyBatisのSQL共通化で<sql>と<include>が担う役割
SQL断片の定義と参照を分けて考える
<sql id="..."> は、再利用するSQLの一部分に名前を付ける要素です。<include refid="..."> は、その名前を指定して断片を取り込みます。
たとえば、取得列を定義する userColumns を複数のSELECTから参照すると、列リストを1か所で管理できます。<sql> 自体をMapperメソッドから呼び出して実行するわけではありません。実行対象は、断片を取り込んだ <select> などのステートメントです。
固定SQL断片の再利用と動的SQLの違い
SQL断片の再利用は「同じ記述をどこにまとめるか」という話です。一方、動的SQLは「入力に応じてどの条件やSQLを組み立てるか」を扱います。
この記事では、列リストや status = #{status} のように構造が固定された断片を対象にします。検索値が呼び出しごとに変わっても、条件式の構造は固定したままです。なお、<sql> の中に動的SQLの要素を含めることもできるため、固定SQLだけに使える機能という意味ではありません。
未入力なら条件を省く処理や、条件の選択・繰り返しが必要な場合は、動的SQLの記事で if・choose・foreach などを確認してください。
<sql>と<include>で列リストを共通化する
<sql id="…">で共通の列リストを定義する
例では、users テーブルに id・name・email・status の列があり、id は主キーとします。取得結果を受ける com.example.domain.User は、引数なしコンストラクタと、Long id・String name・String email に対応するgetter/setterを持つJavaBeanを前提にします。
まずは、取得する3列を userColumns として定義します。次の要素は、Mapper XMLの <mapper> 直下に置きます。
<sql id="userColumns">
  id, name, email
</sql>
ここでは列名と列間のカンマだけを持たせ、SELECTやFROM、末尾のカンマは含めません。断片に含める範囲をそろえると、参照側で何を補えばよいか分かりやすくなります。
<include refid="…">で複数のSELECTから参照する
一覧取得とID検索から、同じ列リストを参照する例です。refid に、先ほど定義した userColumns を指定します。
<mapper namespace="com.example.mapper.UserMapper">
  <sql id="userColumns">
    id, name, email
  </sql>

  <select id="findAll" resultType="com.example.domain.User">
    SELECT
      <include refid="userColumns"/>
    FROM users
    ORDER BY id
  </select>

  <select id="findById" resultType="com.example.domain.User">
    SELECT
      <include refid="userColumns"/>
    FROM users
    WHERE id = #{id}
  </select>
</mapper>
対応するMapperインターフェースは次のとおりです。ID検索では @Param("id") を付け、XMLから参照する名前を明示します。IDにはnullではない値を渡す前提です。
package com.example.mapper;

import com.example.domain.User;
import java.util.List;
import org.apache.ibatis.annotations.Param;

public interface UserMapper {
    List<User> findAll();

    User findById(@Param("id") Long id);
}
userColumns は断片を識別する名前なので、同名のJavaメソッドは不要です。Javaメソッドに対応するのは、findAll と findById というSELECTのIDです。
展開後のSQLで列名・カンマ・空白を確認する
findById の断片を展開し、値の部分をJDBCのプレースホルダで表すと、SQLの構造は次のようになります。
SELECT
  id, name, email
FROM users
WHERE id = ?
<include> は、列間のカンマを補ったり、不要なカンマを取り除いたりする機能ではありません。たとえば参照側で status を追加するなら、<include refid="userColumns"/>, status のように区切りが必要です。
断片単体だけでなく、前後のSQLと合わせて確認してください。列名の重複や曖昧さ、末尾のカンマ、キーワード間の空白や改行を見ると、切り出した境界の問題を見つけやすくなります。
固定条件片を共通化し、値は#{}で渡す
WHEREやANDをどちらが持つか決める
同じステータス条件で一覧と件数を取得するなら、条件式も共通化できます。ここでは、断片は条件式だけを持ち、WHEREや条件間のANDは参照側が持つというルールにします。
次の要素を、先ほどの UserMapper の <mapper> 内に追加します。列リストには既存の userColumns を使います。
<sql id="userStatusPredicate">
  status = #{status}
</sql>

<select id="findByStatus" resultType="com.example.domain.User">
  SELECT
    <include refid="userColumns"/>
  FROM users
  WHERE
    <include refid="userStatusPredicate"/>
  ORDER BY id
</select>

<select id="countByStatus" resultType="long">
  SELECT COUNT(*)
  FROM users
  WHERE
    <include refid="userStatusPredicate"/>
</select>
この断片に後からWHEREを追加すると、参照側と合わせてWHEREが二重になります。逆に、先頭にANDを付けた断片をそのままWHEREの直後へ置くと、不正なSQLになります。WHEREを含む方式も選べますが、定義側と参照側で担当を統一する必要があります。
条件の有無が変わる設計では、where や trim による調整も検討します。ここで示した固定条件片は、<include> だけで条件の有無や接続語を調整するものではありません。
条件片が参照するパラメータ名を呼び出し元でそろえる
userStatusPredicate は #{status} を参照します。そのため、この断片を使う両方のメソッドで、status という名前の値を参照できるようにします。次のメソッドを UserMapper に追加します。
List<User> findByStatus(@Param("status") String status);

long countByStatus(@Param("status") String status);
例では、アプリケーション側で確認した、nullではないステータス値を渡す前提です。値を指定しなくても条件式が自動で省略されるわけではありません。
片方だけ @Param("state") に変えると、断片が要求する status と名前が合わなくなります。また、条件オブジェクトを @Param("condition") で渡す設計なら、参照が #{condition.status} になる場合があります。共通化するときは、SQLの文字列だけでなく、参照するパラメータ名とその階層もそろえてください。
include propertyのロード時展開で注意すること
Mapper XMLに固定した別名をpropertyで指定する
列リストにテーブルの別名を付けたい場合、<include> の子要素に <property> を置き、断片内の置換に使う文字列を指定できます。ここでは、開発者がMapper XMLに固定した u だけを指定します。
次の断片とSELECTも、同じ <mapper> 内へ追加する例です。
<sql id="userColumnsWithAlias">
  ${alias}.id, ${alias}.name, ${alias}.email
</sql>

<select id="findByIdWithAlias"
        resultType="com.example.domain.User">
  SELECT
    <include refid="userColumnsWithAlias">
      <property name="alias" value="u"/>
    </include>
  FROM users u
  WHERE u.id = #{id}
</select>
対応するMapperメソッドは次のとおりです。
User findByIdWithAlias(@Param("id") Long id);この例の ${alias} は、Mapper XMLのロード時にincludeが展開される過程で u に置換されます。列リストは u.id, u.name, u.email となり、FROMで宣言した別名と対応します。
別名が常に同じなら、最初から断片に u.id などと書く方法でも十分です。propertyを使うのは、参照側ごとに固定した別名を指定する必要がある場合に絞ると、定義を追いやすくなります。
propertyはJavaメソッド引数を渡す仕組みではない
<property name="alias" value="u"/> は、Mapper定義を組み立てるための指定です。Javaメソッドを呼ぶたびに引数を受け渡す処理ではありません。上のメソッドに alias 引数がないのも、そのためです。
また、value="#{alias}" と書いても、Java引数をロード時に取り出してテーブルの別名にすることはできません。#{} は実行時に値をバインドするための記法で、列名や別名を組み立てる用途とは異なります。
この例では、別名の u はMapper XMLに固定した構造の一部です。検索するIDはJavaメソッドの引数で受け取り、#{id} を通じて実行時に渡します。
ロード時の置換と実行時の値バインドを区別する
処理の流れを2段階に分けると、違いが見えます。まずinclude propertyで別名を展開すると、SQLの記述は概念的に次の形になります。
SELECT u.id, u.name, u.email
FROM users u
WHERE u.id = #{id}
次に、通常のPreparedStatementとして実行する際は、IDの位置を ? とするSQLに対して、メソッド引数の値をバインドします。
SELECT u.id, u.name, u.email
FROM users u
WHERE u.id = ?
${} という見た目だけで、すべてを実行時の置換と考えないことが大切です。この例の ${alias} は、include propertyによってロード時に解決されるものです。
一方、実行時のSQLで入力値を ${} により直接埋め込むと、SQLの構造を変えてしまう危険があります。この別名の例を、リクエスト由来の文字列を自由に埋め込む方法へ広げないでください。#{} と ${} の詳しい使い分けや、列名などを動的に選ぶ場合の注意は、次の記事で扱っています。
SQL断片とinclude propertyについての公式資料は、MyBatis公式日本語ドキュメント:sqlです。
SQLをどこまで共通化するかの設計基準
同じ意味で一緒に変更する断片をまとめる
共通化の判断では、文字列が一致していることに加えて、同じ理由で一緒に変更する部分かを確認します。
たとえば、同じ検索機能の一覧取得と件数取得に使う条件は、絞り込みの意味をそろえたい部分です。条件片を共有すると、片方だけ修正して一覧と件数が食い違う事態を防ぎやすくなります。
一方、管理画面と外部向け画面で、たまたま取得列が一致しているだけなら、将来も同じ列を返すとは限りません。共通の列リストへ項目を追加した結果、不要な情報まで取得する参照先が増えるなら、用途ごとに分けたほうが意図を保てます。
短い記述まで細かく分割すると、1つのSQLを読むために多くの定義を往復することになります。重複を減らす効果と、展開後のSQLを追う負担の両方を見て判断してください。
列・別名・パラメータへの依存が分かる名前を付ける
commonSql のような広い名前だけでは、何を取り込むのか分かりません。userColumns なら列リスト、userStatusPredicate ならステータスの条件式、userColumnsWithAlias なら別名を使う列リストと読み取れます。
名前だけで表しきれない前提は、断片の近くへコメントとして残します。たとえば userStatusPredicate には「statusパラメータが必要」「WHEREと先頭のANDを含まない」、userColumnsWithAlias には「alias propertyが必要」といった情報が役立ちます。
断片に固定の u. を書く場合は、参照側がFROMやJOINで u を宣言する必要もあります。共通断片は単独で完結するとは限らないため、依存する名前を読み手が追えるようにしておきます。
別namespaceへの参照と深いincludeの入れ子は必要性を見極める
同じnamespace内の断片は、例のように短いIDで参照できます。別namespaceにある断片は、namespace.id の形で指定します。たとえば com.example.mapper.SharedUserSql に userColumns を定義しているなら、参照は次の形です。
<include refid="com.example.mapper.SharedUserSql.userColumns"/>この参照には、対象のnamespaceと断片を定義したMapper XMLもMyBatisに読み込まれている必要があります。別ファイルに置くだけで利用できるわけではありません。
namespaceをまたぐ共有は、変更の影響も複数のMapperへ広げます。また、断片から別の断片を参照する入れ子を深くすると、取得列や必要なパラメータを把握しにくくなります。まず同じMapper内でまとめ、複数のMapperで同じ意味を共有する必要が明確になってから範囲を広げると、依存関係を管理しやすくなります。
共通SQL断片を変更するときの確認点
id・refid・namespaceの対応を確認する
断片の名前を変更した場合は、すべての refid を確認します。同じファイルの参照だけでなく、別namespaceからの完全修飾名による参照や、別の断片を経由する間接参照も対象です。
<sql id="...">と<include refid="...">が対応しているか- 移動先のnamespaceを含めて、参照名が正しいか
- 参照されるMapper XMLが読み込み対象になっているか
- 必要なinclude propertyを、各参照箇所で指定しているか
Mapperの読み込み確認で定義の問題を調べた後は、参照するステートメントをデータベース上で実行し、SQL構文や取得結果も確認します。
参照先すべてのSQL構文・取得列・バインド値を確認する
共通断片の変更は、取り込んでいるSQLすべてに影響します。代表の1件だけでなく、直接・間接に参照する各ステートメントについて、次の点を確認してください。
- SQL構文:カンマ、WHERE、AND、括弧、空白のつながりが正しいか。別名が宣言され、列名が曖昧になっていないか。
- 取得列:必要な列が残っているか。追加した列や列の別名が、戻り値の型や結果マッピングと対応するか。
- バインド値:
#{}の参照名とMapper引数が一致するか。意図した値・型・順序で渡されるか。 - 検索の意味:条件の追加や変更によって、対象データや一覧と件数の対応が変わっていないか。
例の userStatusPredicate を変更したなら、findByStatus と countByStatus の両方を確認します。テスト用データには該当するステータスと該当しないステータスを用意し、取得対象と件数が意図どおりかを確かめると、構文だけでは見つからない条件の問題も調べられます。
利用環境では、生成されたSQLとパラメータの対応を確認したうえで、使用するデータベースに対するテストを行ってください。共通化できたことと、すべての参照先で正しく動くことは、それぞれ確認が必要です。
まとめ
MyBatisのSQL共通化は、<sql> で断片を定義し、<include> で参照する形から始められます。まずは同じMapper内の列リストや、同じ検索の意味を持つ固定条件片をまとめると、適用範囲を把握しやすくなります。
- 断片と参照側で、カンマ・WHERE・ANDの担当を決める。
- 条件片が使うパラメータ名をそろえ、検索値は
#{}で渡す。 - include propertyのロード時展開と、実行時の値バインドを区別する。
- 同じ意味で一緒に変更する部分を共有し、別名やパラメータへの依存を明確にする。
- 断片を変更したら、参照先すべてのSQL・取得列・バインド値を確認する。
共通化する範囲は、修正漏れを減らしながら、SQL全体の意味を追えるかどうかで判断してください。小さな断片から始め、参照側との約束を明確にしておくことが、変更しやすいMapper XMLにつながります。
コメント