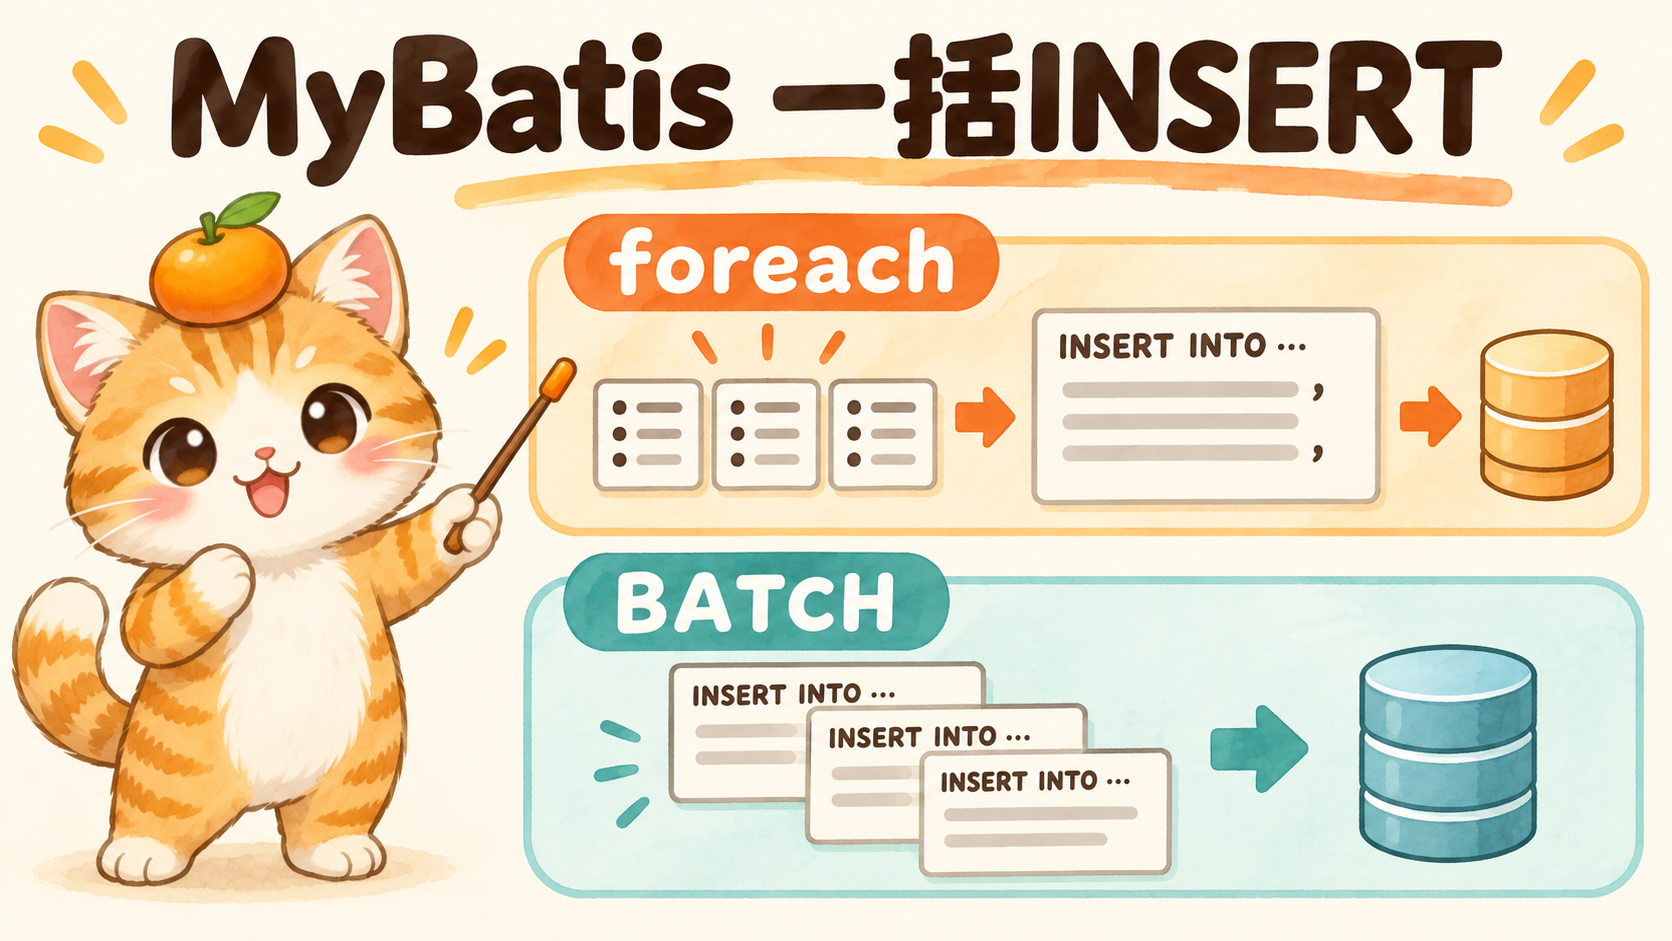
MyBatisで複数レコードを登録するときは、foreachで複数行のVALUESを持つINSERTを作る方法と、ExecutorType.BATCHで単件INSERTを繰り返しバッチ実行する方法が候補になります。
選ぶ際に確認したいのは、登録件数だけではありません。SQLの大きさ、DBとJDBCドライバの対応、実行結果を確認するタイミング、途中で失敗した場合に取り消す範囲も関係します。この記事では、同じ登録対象を使って2つの方法を説明し、分割実行とトランザクションの設計まで整理します。
MyBatisの一括INSERTには2つの方式がある
foreachで複数行のVALUESを持つINSERTを組み立てる
foreachは、Listなどを繰り返してSQLの一部を組み立てる機能です。一括INSERTでは、各要素に対応する値の組をカンマでつなぎます。2件を登録する場合、生成されるSQLは概念的に次の形になります。
INSERT INTO users (name, email)
VALUES (?, ?), (?, ?)複数の行を1つのINSERT文で登録するのが、この使い方の特徴です。セミコロンで単件INSERTを並べる方法とは異なります。ただし、この複数行VALUES構文をすべてのDBで利用できるとは限りません。
ExecutorType.BATCHで同じINSERT文を繰り返しバッチ実行する
ExecutorType.BATCHは、MyBatisの実行方式の指定です。単件INSERTのMapperを繰り返し呼び出し、処理を蓄積してJDBCのバッチ実行へ渡します。Mapperに書くSQLは、次のような1行分の形にできます。
INSERT INTO users (name, email)
VALUES (?, ?)Java側では登録対象ごとにMapperを呼びますが、その直後の戻り値で登録完了を判断しません。明示的に結果を確認するときは、flushStatements()で蓄積した処理を実行します。
SQLの形・実行単位・結果の確認方法を比較する
| 比較項目 | foreachによる複数行INSERT | 単件INSERTのBATCH実行 |
|---|---|---|
| 中心になる仕組み | SQLの組み立て | SQLの実行方式 |
| MapperのSQL | 複数行分のVALUESを持つ | 1行分のVALUESを持つ |
| Javaからの呼び出し | リストを分割した単位で呼ぶ | 登録対象ごとに呼ぶ |
| 実行結果の確認 | SIMPLEで実行する例ではMapperの戻り値 | flush後のBatchResultと更新件数 |
| 主な制約 | DB構文、プレースホルダー数、SQLサイズ | ドライバの対応、蓄積量、バッチ結果の表現 |
| 登録の確定 | トランザクションのcommit | トランザクションのcommit |
foreachとBATCHは、役割が違うため組み合わせることもできます。ただし、複数行INSERTをさらにバッチ実行すると、分割単位と結果の対応が複雑になります。ここでは違いを追いやすくするため、複数行INSERTをSIMPLEで実行する例と、単件INSERTをBATCHで実行する例を比較します。
foreachで複数行INSERTを書く方法
サンプルのDB構文とJava・Mapper構成の前提
登録先はusersテーブルで、登録する列はnameとemailです。ほかの必須列がある場合は、DB側で値を補えるか、INSERTに含める必要があります。複数行INSERTの例はVALUES (...), (...)を利用できるDB向けです。テーブル定義や列の長さは、採用DBと業務仕様に合わせて用意してください。
Java側では、1行分の入力を次のクラスで表します。この段階では生成キーを取得しません。
package com.example.bulk;

public final class UserRow {
    private final String name;
    private final String email;

    public UserRow(String name, String email) {
        this.name = name;
        this.email = email;
    }

    public String getName() {
        return name;
    }

    public String getEmail() {
        return email;
    }
}以降は、接続先とJDBCトランザクション管理を設定したSqlSessionFactoryを利用でき、Mapper XMLの読み込みも設定済みとします。namespaceとメソッド名の対応を確認したい場合は、Mapper XMLの基本記事が補足になります。
Listを受け取るMapperとVALUESを展開するXML
比較用に、複数行INSERTと単件INSERTを同じMapperへ定義します。insertManyには@Param("rows")でリストの参照名を付けます。
package com.example.bulk;

import java.util.List;
import org.apache.ibatis.annotations.Param;

public interface UserBulkMapper {
    int insertMany(@Param("rows") List<UserRow> rows);
    int insertOne(UserRow row);
}
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN"
"https://mybatis.org/dtd/mybatis-3-mapper.dtd">
<mapper namespace="com.example.bulk.UserBulkMapper">
<insert id="insertMany">
INSERT INTO users (name, email)
VALUES
<foreach collection="rows" item="row" separator=",">
(#{row.name}, #{row.email})
</foreach>
</insert>
<insert id="insertOne">
INSERT INTO users (name, email)
VALUES (#{name}, #{email})
</insert>
</mapper>collection="rows"はMapperの引数名、item="row"は各要素の参照名です。separator=","で行と行の間にカンマを入れ、各行の括弧はforeachの内側に書きます。値は#{}でバインドし、文字列置換の${}には渡しません。
foreachの属性やIN句への展開は、動的SQLの記事で補足しています。本記事では、VALUESの行を組み立てる用途に絞ります。
null・空リスト・不正な要素を呼び出し前に扱う
空リストを渡すと、このXMLではVALUESの後に行が生成されず、不正なSQLになります。foreachだけで処理を完結させず、呼び出し側で扱いを決めます。以下のサンプルでは、リスト自体のnullと不正な要素は例外、空リストは何も登録せず終了とします。
次のクラスは、入力を確認してからリストを分割し、全件を1つのトランザクションで登録する例です。chunkSizeは呼び出し元から受け取り、普遍的な推奨値は置いていません。
package com.example.bulk;

import java.util.ArrayList;
import java.util.List;
import java.util.Objects;
import org.apache.ibatis.session.ExecutorType;
import org.apache.ibatis.session.SqlSession;
import org.apache.ibatis.session.SqlSessionFactory;

public class UserBulkWriter {
    private final SqlSessionFactory factory;

    public UserBulkWriter(SqlSessionFactory factory) {
        this.factory = Objects.requireNonNull(factory);
    }

    public void insertWithForeach(List<UserRow> input, int chunkSize) {
        List<UserRow> rows = validateAndCopy(input, chunkSize);
        if (rows.isEmpty()) {
            return;
        }

        try (SqlSession session =
                factory.openSession(ExecutorType.SIMPLE, false)) {
            try {
                UserBulkMapper mapper =
                    session.getMapper(UserBulkMapper.class);

                for (int start = 0; start < rows.size();) {
                    int end = start + Math.min(
                        chunkSize, rows.size() - start);
                    int affected = mapper.insertMany(
                        rows.subList(start, end));

                    if (affected != end - start) {
                        throw new IllegalStateException(
                            "登録件数が想定と異なります");
                    }
                    start = end;
                }
                session.commit();
            } catch (RuntimeException | Error failure) {
                rollbackPreservingFailure(session, failure);
                throw failure;
            }
        }
    }

    private static List<UserRow> validateAndCopy(
            List<UserRow> input, int chunkSize) {
        if (chunkSize <= 0) {
            throw new IllegalArgumentException(
                "分割サイズは正の整数にしてください");
        }
        if (input == null) {
            throw new IllegalArgumentException("リストがnullです");
        }

        List<UserRow> rows = new ArrayList<>(input);
        for (UserRow row : rows) {
            if (row == null
                    || row.getName() == null
                    || row.getName().trim().isEmpty()
                    || row.getEmail() == null
                    || row.getEmail().trim().isEmpty()) {
                throw new IllegalArgumentException(
                    "登録要素と必須項目を確認してください");
            }
        }
        return rows;
    }

    private static void rollbackPreservingFailure(
            SqlSession session, Throwable failure) {
        try {
            session.rollback();
        } catch (RuntimeException | Error rollbackFailure) {
            failure.addSuppressed(rollbackFailure);
        }
    }
}
openSession(ExecutorType.SIMPLE, false)のfalseは、自動コミットを無効にする指定です。例外時はrollbackを試み、rollback自体の失敗も元の例外に保持します。SqlSessionはtry-with-resourcesで閉じます。
この入力検証は最小限です。文字列の長さ、メールアドレスの形式、重複、入力全体の最大件数などは業務仕様に合わせて追加してください。DBの一意制約なども必要で、事前検証だけで登録成功が決まるわけではありません。また、更新件数の一致判定は、通常のINSERTで入力件数分の登録を期待する例です。重複無視やUPSERTへ変更する場合は、結果の契約も見直します。
プレースホルダー数とSQLサイズを考えて分割する
サンプルは1行につき2個のプレースホルダーを使うため、N行なら2N個になります。一般には、1行あたりのバインド数×行数+行の外にあるバインド数を数えます。上限が分かれば分割サイズの制約を計算できますが、その上限いっぱいでの運用が適切とは限りません。
DBやドライバが扱えるパラメータ数のほか、VALUESの行数制限、SQL文の長さ、バインドデータを含む送信サイズも確認します。同じ件数でも、登録列が多い場合や長い文字列を含む場合は負荷が変わります。
前のコードではchunkSizeごとにSQLを分けますが、commitは最後の1回です。分割はSQLを小さくするためのものであり、登録の確定範囲を小さくする処理ではありません。
ExecutorType.BATCHで複数件を登録する方法
単件INSERTのMapperをBATCHのSqlSessionから呼ぶ
BATCHでは、先ほどのinsertOneを使います。次のメソッドをUserBulkWriterクラス内に追加してください。共通の入力検証とrollback処理を使い、Mapperは必ずここで開いたBATCHのSqlSessionから取得します。
このメソッドは、指定件数ごとにflushして結果を確認し、全件分が成功してからcommitします。後述するcheckBatchResultsも同じクラスへ追加します。
public void insertWithBatch(List<UserRow> input, int flushSize) {
    List<UserRow> rows = validateAndCopy(input, flushSize);
    if (rows.isEmpty()) {
        return;
    }

    try (SqlSession session =
            factory.openSession(ExecutorType.BATCH, false)) {
        try {
            UserBulkMapper mapper =
                session.getMapper(UserBulkMapper.class);
            int pending = 0;

            for (UserRow row : rows) {
                mapper.insertOne(row);
                pending++;

                if (pending == flushSize) {
                    checkBatchResults(session.flushStatements());
                    pending = 0;
                }
            }

            if (pending > 0) {
                checkBatchResults(session.flushStatements());
            }
            session.commit();
        } catch (RuntimeException | Error failure) {
            rollbackPreservingFailure(session, failure);
            throw failure;
        }
    }
}
分割サイズに満たない最後の残りもflushします。Mapperへ渡すオブジェクトは行ごとに用意し、投入後に同じインスタンスを書き換えて使い回さない構成にします。特に生成キーを受け取る場合は、入力と結果の対応を保つことが大切です。
flushStatementsで実行結果を確認する
flushStatements()の戻り値はList<BatchResult>です。BatchResultは実行のまとまりに対応し、そのgetUpdateCounts()からJDBCが返した更新件数の配列を取得します。Listの要素数が、そのまま登録した行数になるわけではありません。
次のimportをUserBulkWriterへ追加します。
import java.sql.Statement;
import org.apache.ibatis.executor.BatchResult;
結果確認のメソッドは次のとおりです。この例は単件INSERTなので、具体的な件数が返った場合は1を期待します。正確な件数が返らない成功結果については、業務上許容する方針にしています。
private static void checkBatchResults(List<BatchResult> results) {
    for (BatchResult result : results) {
        for (int count : result.getUpdateCounts()) {
            if (count == Statement.EXECUTE_FAILED) {
                throw new IllegalStateException(
                    "バッチ内に失敗した処理があります");
            }
            if (count == Statement.SUCCESS_NO_INFO) {
                // 成功だが、正確な更新件数は取得できない。
                continue;
            }
            if (count != 1) {
                throw new IllegalStateException(
                    "単件INSERTの更新件数が想定と異なります");
            }
        }
    }
}
失敗時には、結果リストを受け取る前にflush自体が例外を投げることもあります。そのため、更新件数の確認と、flushを含む処理全体の例外処理の両方が必要です。失敗を表す値が常に通常の戻り値として届く、と考えないようにしてください。
Mapperの戻り値とバッチ実行後の更新件数を区別する
BATCHのinsertOneを呼んだ直後のint値は、登録件数として扱えません。SIMPLEの例と同じ感覚でinsertOne(row) != 1を判定したり、その戻り値を合計したりしないでください。
| 確認対象 | 意味と扱い |
|---|---|
| BATCHのMapper呼び出し直後の戻り値 | 実際の更新件数として使わない |
| flush後の0以上の更新件数 | JDBCが報告した件数。SQLの契約と照合する |
| Statement.SUCCESS_NO_INFO | 実行成功だが正確な件数は不明 |
| Statement.EXECUTE_FAILED | 該当する処理の実行失敗を表す |
| commitの成功 | トランザクションの確定を確認する段階 |
SUCCESS_NO_INFOを1件へ置き換えて合計すると、確認していない件数を確定値として扱うことになります。正確な件数が必須なら、この値を受け入れるかを見直し、入力と対応する業務キーで保存結果を照合するなど、別の確認方法を設計してください。
SQLの変化や途中のSELECTが実行のまとまりに与える影響
BATCHでは、同じMapper定義で同じSQLの呼び出しが連続するかが、実行のまとまりに関係します。動的SQLで登録列が変わったり、別のMapper定義を挟んだりすると、まとまりが分かれます。値だけが違う場合と、SQL文字列自体が違う場合を区別しましょう。
また、同じSqlSessionで途中にSELECTを入れると、DBへの検索実行に先立って保留中の処理がflushされる場合があります。SELECTを「状態を読むだけ」と考えてループ内へ追加すると、想定した蓄積単位が変わり得ます。結果確認はSELECTによる暗黙のflushに任せず、明示的なflushStatements()で行う設計にすると追いやすくなります。
JDBCドライバがバッチをどのように送信・変換するかも環境に依存します。Mapperの呼び出し回数やflushの回数だけから、ネットワーク通信回数を断定することはできません。
分割実行とトランザクションの範囲を決める
flush・commit・rollbackの役割を整理する
| 操作 | 役割 | 注意点 |
|---|---|---|
| flushStatements | 保留中のバッチを実行して結果を取得する | 自動コミット無効の例では登録の確定ではない |
| commit | トランザクションを確定する | 未実行のバッチがあれば、その実行も伴う |
| rollback | 未確定の変更を取り消し、保留中のバッチを破棄する | すでにcommitした変更は取り消せない |
上のサンプルでcommit前に明示的にflushしているのは、バッチ結果を確認するためです。commitまで処理を保留できても、その途中結果を確認せずに確定してよいとは限りません。制約の評価タイミングなどによっては、flushが成功してもcommit時に失敗することがあります。
flushは実行の区切り、commitは確定の区切りです。何回flushしても、それだけでトランザクションを分割したことにはなりません。
分割サイズとコミット単位を分けて設計する
複数行INSERTの分割サイズは、主に1つのSQLの大きさを調整します。BATCHのflushサイズは、実行前に蓄積する処理量を調整します。一方、コミット単位は「どの範囲をまとめて成功または失敗にするか」という業務上の判断です。
全件をまとめて確定すれば、途中の失敗で全件を取り消す設計にできます。ただし、長いトランザクションによるロックやDB側のログ負荷は残ります。途中でflushしても、これらの負荷がすべて解消するわけではありません。
分割ごとにcommitする設計では、先に確定した分が残ります。部分成功を許容できることに加え、処理済み範囲を記録し、残りを再開できる仕組みが必要です。
途中で失敗した場合の取り消し範囲と再実行を考える
サンプルは、同じSqlSessionの同じトランザクションで最後にcommitする構成です。トランザクションに対応したテーブルを使い、rollbackが正常に完了すれば、前の分割で実行した未確定のINSERTも取り消す対象になります。外部システムへの通知など、DBトランザクション外の処理まで取り消されるわけではありません。
バッチの途中で失敗したとき、ドライバが後続の処理を続けるか、どこまでの更新件数を返すかは対応状況によります。更新件数の配列だけを見て、全件が未登録だったと判断しないでください。
特にcommit中の通信切断では、アプリケーションに成功応答が届かなくても、DB側では確定している可能性があります。rollbackを呼び出したことだけで、未登録だったと断定することもできません。再実行前に登録状態を照合し、業務キーや取り込み識別子、一意制約などで二重登録を防ぐ設計にします。
手動のSqlSession管理とSpring管理の境界を確認する
掲載コードはMyBatis単体でSqlSessionを開き、commit・rollback・closeを自分で管理する例です。Spring管理のMapperを使うServiceへ、そのまま混ぜる構成ではありません。
Spring連携では、BATCHを使うSqlSessionTemplateなどの設定と、Spring側のトランザクション境界をそろえます。Spring管理のSqlSessionに対して手動でcommit・rollback・closeを行わず、トランザクション管理へ任せます。
同一トランザクションで異なるExecutorTypeを混在させる構成には制約があるため、BATCH用の設定だけを追加して済ませないことも必要です。接続先、トランザクションへの参加、例外時のrollback条件を確認してください。例外を捕捉して正常終了へ変える処理も、取り消しの判断に影響します。
複数件登録で生成キーを取得するときの注意点
DB・JDBCドライバの対応と各オブジェクトへの割り当てを確認する
生成キーが必要な場合は、useGeneratedKeysやkeyPropertyによる取得を検討します。ただし、単件の通常実行で取得できたことは、複数行INSERTやBATCHでも全件分を正しく取得できる証明にはなりません。
掲載したUserRowは入力専用です。生成キーを受け取る例へ変更する場合は、IDを書き込めるプロパティを持つ型へ変更し、Mapperの引数構造に合うkeyPropertyを設定します。リストに付けた引数名とforeach内の一時的な変数名を混同しないようにしてください。
- 採用DBとJDBCドライバが、対象方式で全件分の生成キーを返すか
- MyBatisが各入力オブジェクトの正しいプロパティへ割り当てられるか
- keyColumnなどの追加指定が必要か
- 分割した最後の端数やドライバ設定の変更後も対応関係が保たれるか
IDがnullでないことだけでなく、各入力の業務キーとDB上の行を照合してください。最初に得たIDへ連番を足して残りを推測する方法では、各行との対応を保証できません。単件での取得設定と受け取り先の基本は、次の記事で確認できます。
IDを参照できるタイミングとコミットの完了を区別する
JDBCの生成キー取得を使うBATCHでは、Mapper呼び出し直後はまだINSERTが実行されておらず、IDを利用できないことがあります。後続処理でIDが必要なら、明示的にflushし、対応環境でIDの割り当てが完了したことを確認してから使います。
IDが入っていても、commitが完了したとは限りません。後続処理が失敗してrollbackした後も、JavaオブジェクトのIDが自動的にnullへ戻るわけではありません。再利用するオブジェクトの状態にも注意してください。
親をまとめて登録してから子を登録する設計では、親のflush、生成キーと親オブジェクトの照合、子へのID設定、子の登録、全体のcommitという順序を検討します。全件のキー対応を確認できない環境では、その方式を前提に後続処理を組み立てないようにします。
foreachとBATCHを選ぶための確認ポイント
件数だけで決めずDB構文・ドライバ設定・登録列数を確認する
複数行VALUESを利用でき、SQLとパラメータを無理のない大きさに分けられるなら、foreachによる複数行INSERTが候補になります。単件INSERTのSQLを保ち、一定量ごとにまとめて実行したいなら、BATCHが候補です。
どちらが速いかは、DB、JDBCドライバ、登録列数、値の大きさ、インデックス、制約、生成キー取得の有無などに左右されます。ドライバにバッチの書き換えや最適化の設定があっても、名称や効果を共通のものとして扱わず、採用ドライバの資料で確認します。
メモリ・SQLサイズ・生成キー・原子性の要件を比較する
| 確認する要件 | 設計で見る点 |
|---|---|
| SQLサイズ | foreachで展開した行数とバインド数を制限できるか |
| メモリ | 入力全体と、SQL・バッチ・結果の保持量を分けて評価できるか |
| 生成キー | 全件のキーを取得し、入力との対応を確認できるか |
| 原子性 | 全件をまとめて確定する必要があるか、部分成功を許容するか |
| 再実行 | 確定済みの範囲を識別し、二重登録を防げるか |
| 結果確認 | 正確な更新件数が必須か、件数不明の成功を許容できるか |
掲載サンプルは入力全体をListとして受け取り、検証のためにリストをコピーしています。SQLやflushを分割しても、入力全体のメモリ使用量は減りません。入力が大きい場合は読み込みも分割する設計が必要ですが、全件の事前検証ができなくなる点と、途中失敗時の扱いを合わせて検討します。
対象環境で正常登録・境界条件・途中失敗を検証する
採用前に、以下の項目を検証してください。Mapperをモックにしたテストだけでは、DB構文、ドライバの更新件数、生成キーの対応を確認できないため、対象DBとドライバを使う結合テストを用意します。
| 検証ケース | 確認すること |
|---|---|
| null・空リスト・null要素・必須値不足 | 契約どおりに拒否または終了し、不要なINSERTを実行しない |
| 1件、分割サイズと同数、その前後 | 分割の境界と最後の端数で漏れ・重複がない |
| 引用符や日本語、長い値を含む入力 | 値がバインドされ、列長や送信サイズの制約を適切に扱う |
| 途中の分割で一意制約違反 | 例外とrollbackを確認し、全件確定方式では先行分も残らない |
| 分割ごとにcommitする別設計 | 先行分が残ることと、再開位置・重複防止が契約どおりである |
| BATCHの更新件数 | 具体的な件数とSUCCESS_NO_INFOを区別する |
| 生成キーあり | 全件のIDと入力行の対応、flush前後、rollback後の状態を確認する |
| commit時の障害 | 結果不明の状態を識別し、照合前に再登録しない |
速度を比較する場合は、同じ入力、同じコミット単位、同じ生成キー要件をそろえ、commitまでの処理時間とメモリ使用量を確認します。BATCHのMapper呼び出しが終わるまでだけを測ると、ループ内のflushによるSQL実行時間は含まれますが、残りのflushやcommitの時間は含まれません。比較では、commitが完了するまでを計測してください。
公式資料で確認する
- MyBatis公式: Dynamic SQL(foreach) — foreachの属性・動的SQLの仕様
- MyBatis公式: Java API(SqlSession) — ExecutorType.BATCH、flushStatements、commit/rollback
まとめ
MyBatisの一括INSERTでは、foreachは複数行のSQLを組み立てる役割、ExecutorType.BATCHは処理を蓄積してバッチ実行する役割を持ちます。まずSQLの形と実行方式を分けて考えると、実装を選びやすくなります。
- foreachでは、複数行VALUESの対応とSQL・プレースホルダーの上限を確認する
- BATCHでは、Mapper直後の戻り値を登録件数にせず、flush後の結果を確認する
- 分割サイズとコミット単位を別々に決め、失敗時に取り消す範囲を明確にする
- 生成キーは、取得件数・入力との対応・参照タイミングを対象環境で検証する
- 再実行では確定済みの登録を照合し、二重登録を防ぐ
件数だけで方式や分割サイズを固定せず、DB・JDBCドライバの制約と、全件をまとめて成功させる必要があるかを先に確認してください。その条件をそろえて正常系と途中失敗を検証することで、登録結果を確認でき、失敗時にも復旧しやすい実装にできます。
コメント