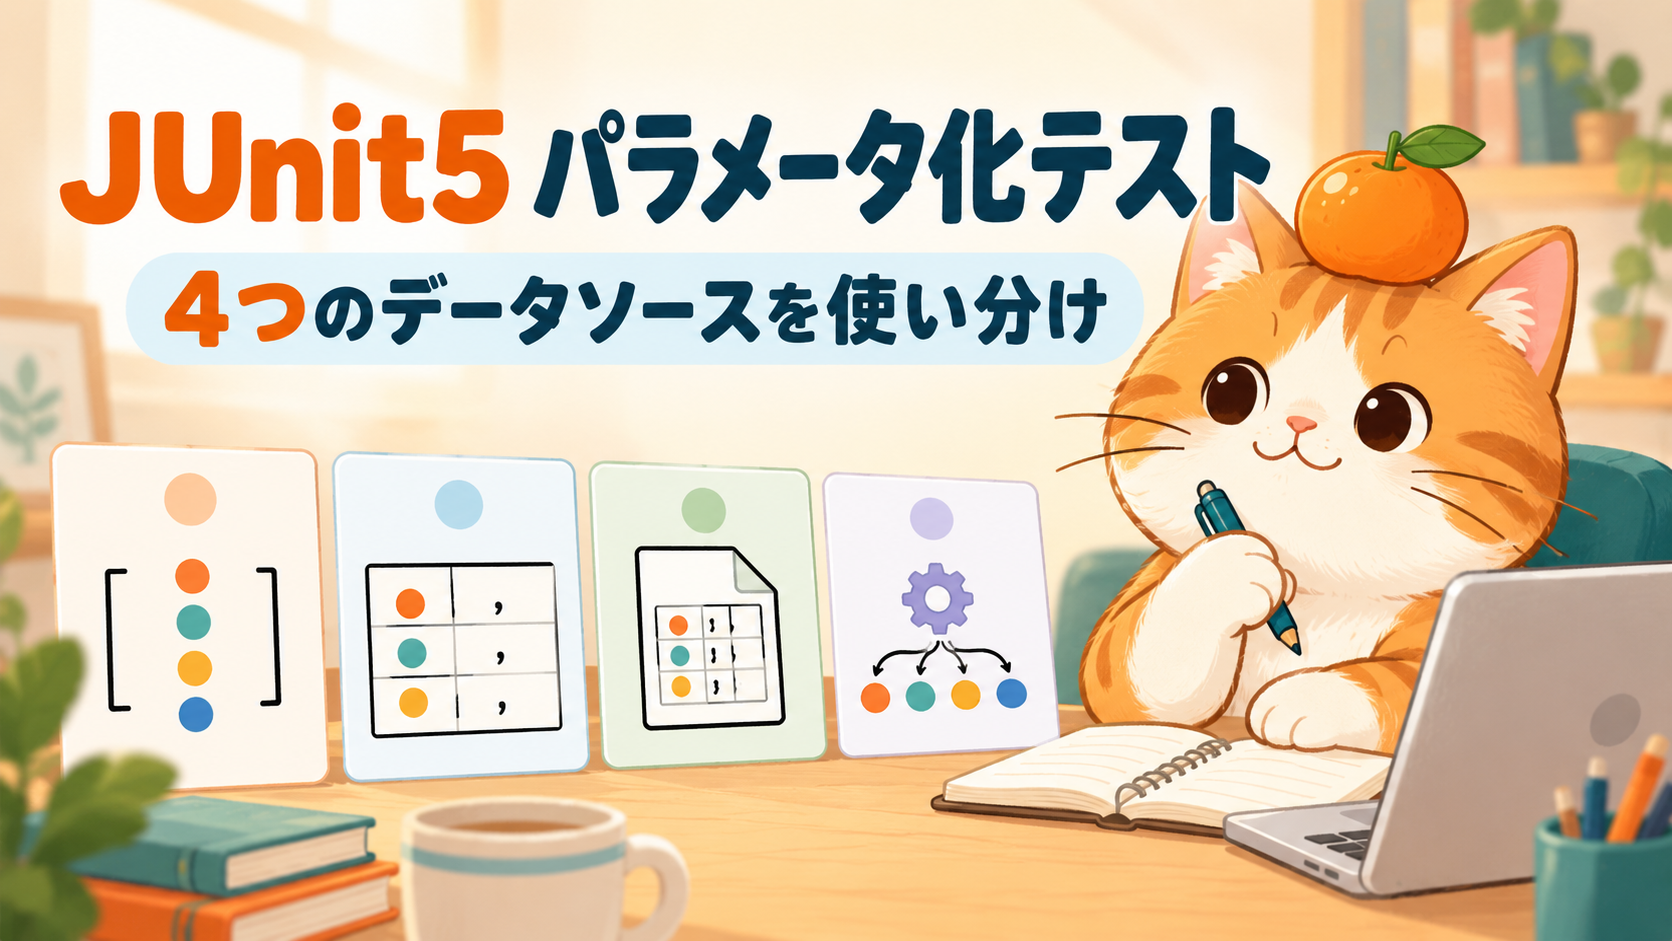
JUnit5のパラメータ化テストを書こうとすると、入力をアノテーションに並べるか、CSVに分けるか、Javaのメソッドで組み立てるかで迷うことがあります。選ぶ基準は、入力の形、期待値との対応、変更するときの読みやすさです。
この記事では、@ValueSource・@CsvSource・@CsvFileSource・@MethodSourceを、範囲判定の説明用コードで比較します。データソースの選択から、境界値の並べ方、CSVの注意点、失敗したケースの読み解き方までを扱います。
基本的なテストの書き方やアサーション、JUnitの導入手順を確認したい場合は、先に次の記事を参照してください。本記事は、JUnit Jupiterのパラメータ化テストを利用できる環境があることを前提にしています。
JUnit5のパラメータ化テストはデータの形と保守性で選ぶ
パラメータ化テストでは、同じテストメソッドに異なるデータを供給します。データソースを選ぶ前に、「何を渡し、何と比較するか」を決めると、無理のない形に整理できます。
4つのデータソースを比較する早見表
| データソース | 入力の形・期待値 | 配置・型の表現 | 変更レビューの見どころ |
|---|---|---|---|
@ValueSource | 単一の値。同じ期待条件を繰り返す用途に向く | アノテーション内。対応する数値・文字列などを列挙する | 少数の入力を見渡しやすい。ケース別の期待値は直接並べられない |
@CsvSource | 複数の列。入力と期待値を同じ行に置ける | アノテーション内。CSVの文字列を引数の型へ変換する | 検証処理とデータを近くに置ける。列数や引用符が増えると読みにくい |
@CsvFileSource | CSVの各レコード。入力と期待値を表として管理する | 外部CSV。読み込んだ値を引数の型へ変換する | データの差分を確認しやすい。テストコードとの対応も確認する必要がある |
@MethodSource | オブジェクトや複数引数。期待値もJavaで記述できる | 供給メソッド。Javaの値やオブジェクトを組み立てる | 構築条件を表現しやすい。供給処理が複雑になると期待結果を追いにくい |
入力・期待値・データの置き場所から選ぶ
入力が1つで、すべてに対して同じ条件を確認するなら@ValueSourceが候補です。「入力9ならfalse、入力10ならtrue」のように結果が変わる場合は、入力と期待値を並べられる@CsvSourceが読みやすくなります。
表形式のデータをテストコードから分離して管理したいなら@CsvFileSource、値を渡す前にオブジェクトの構築が必要なら@MethodSourceを検討します。件数だけで決めず、ケースを追加する人が、入力と期待結果の関係を一度で読めるかを判断基準にしてください。
@ValueSource:単一の入力で同じ条件を検証する
同じ期待条件を持つ入力を並べる実装例
共通の例題として、整数の範囲を表すIntRangeを使います。仕様は「下限と上限を含む」「範囲外の値にはfalseを返す」「下限が上限を超える範囲は作成できず、IllegalArgumentExceptionを投げる」の3点です。
次の対象クラスをIntRange.javaに置きます。以降のテストクラスは、すべてこのクラスを参照します。例ではpackage宣言を省略しているため、プロジェクトに組み込むときは対象クラスとテストクラスのパッケージをそろえてください。
public final class IntRange {
    private final int min;
    private final int max;

    public IntRange(int min, int max) {
        if (min > max) {
            throw new IllegalArgumentException("min must not exceed max");
        }
        this.min = min;
        this.max = max;
    }

    public boolean contains(int value) {
        return min <= value && value <= max;
    }
}範囲10〜20に含まれる入力だけを並べれば、どのケースもassertTrueで検証できます。次はIntRangeValueSourceTest.javaの例です。
import org.junit.jupiter.params.ParameterizedTest;
import org.junit.jupiter.params.provider.ValueSource;

import static org.junit.jupiter.api.Assertions.assertTrue;

class IntRangeValueSourceTest {
    @ParameterizedTest(name = "[{index}] value={0} is inside")
    @ValueSource(ints = {10, 11, 15, 19, 20})
    void containsValuesInsideRange(int value) {
        IntRange range = new IntRange(10, 20);

        assertTrue(range.contains(value));
    }
}intsに並べた各値が、テストメソッドのvalueへ渡されます。検証したいことが「範囲内ならtrue」で統一されているため、データに期待値の列を追加する必要がありません。
ケースごとに期待値が変わるときの切り替え方
範囲外の9や21も同じ表で確認したくなったら、@CsvSourceへ切り替えると入力と期待値の関係を明示できます。範囲内と範囲外でテストメソッドを分け、両方に@ValueSourceを使う方法もあります。
避けたいのは、テストの中にvalue >= 10 && value <= 20という判定をもう一度書き、それを期待値にする形です。対象処理と同じ条件式を複製すると、同じ思い違いが両方へ入り込む余地ができます。ケースごとの期待値は仕様から決め、データとして見える場所へ置きます。
@CsvSource:入力と期待値を表形式で管理する
境界の直前・境界値・直後を並べる実装例
範囲10〜20について、下限の周辺を9・10・11、上限の周辺を19・20・21で確認します。入力と期待値に加えてケース名を持たせると、数字が何を表しているかも読み取れます。
import org.junit.jupiter.params.ParameterizedTest;
import org.junit.jupiter.params.provider.CsvSource;

import static org.junit.jupiter.api.Assertions.assertEquals;

class IntRangeCsvSourceTest {
    @ParameterizedTest(name = "[{index}] {0}: value={1}, expected={2}")
    @CsvSource({
        "below-min, 9, false",
        "at-min, 10, true",
        "above-min, 11, true",
        "below-max, 19, true",
        "at-max, 20, true",
        "above-max, 21, false"
    })
    void containsMatchesBoundaryCases(
            String caseName, int value, boolean expected) {
        IntRange range = new IntRange(10, 20);

        assertEquals(expected, range.contains(value), caseName);
    }
}列は左からcaseName・value・expectedに対応します。期待値の列を見れば、下限と上限を含む仕様が分かります。範囲の中央にある値だけを増やすよりも、境界の包含条件を直接表せる構成です。
空文字・null・空白・引用符の扱いを整理する
CSVで文字列を扱う場合は、空文字、値のないフィールド、空白だけの文字列を区別します。以下は@CsvSourceの既定設定を前提にした整理です。利用バージョンのAPI資料と照合する際は、emptyValue・nullValues・quoteCharacter・ignoreLeadingAndTrailingWhitespaceの設定も確認してください。
| CSVレコードの記述例 | 第1列の意味 | 確認したい点 |
|---|---|---|
'', empty | 空文字 | 引用符で囲んだ空欄。emptyValueの設定で扱いが変わる |
, missing | null | 引用符のない空欄。プリミティブ型では受け取れない |
' ', space | 空白1文字 | 引用符内の空白をデータとして表す |
abc , text | abc | 引用符の外側にある前後の空白は既定で除去される |
'a,b', comma | a,bという1つの値 | 引用符内のカンマは列の区切りにしない |
NULL, marker | 通常は文字列NULL | nullValuesにNULLを指定した場合はnullとして扱う |
@CsvSourceの既定の引用符はシングルクォートです。引用符内でシングルクォート自体を表す場合は重ねて記述するため、CSV上の'it''s'はit'sという値を表します。
さらに、アノテーション内ではCSVレコードをJavaの文字列として書きます。CSVの引用符とJavaの文字列の引用符は別の役割です。表の'', emptyをアノテーションに書く場合は、Java側のダブルクォートで囲んだ"'', empty"になります。
空欄をnullとして渡したいのか、空文字として渡したいのかを先に決めてください。見た目の似たデータでも、対象メソッドに届く値が変わります。空白そのものが検証対象なら、引用符や空白除去の設定までテストデータの一部としてレビューします。
列数と引数の型を確認し、変換時の問題を防ぐ
CSVの値は、テストメソッドの引数型に合わせて変換されます。例の10はint、trueはbooleanとして受け取ります。ただし、任意の文字列を任意の型へ変換できるわけではありません。数値の列にtenを書けば、intへの変換で問題になります。
ケースを追加するときは、列数、列順、各列の意味、受け取る型の4点を確認します。特にnullの可能性がある列は、intではなくIntegerなど、nullを受け取れる型が必要です。もっとも、引数型を変えてエラーを消す前に、そもそもnullを渡す仕様なのかを確認してください。
余分な列が常にエラーになると考えるのも避けましょう。引数数の検証方法や利用バージョンによって扱いを確認する必要があります。この記事のような単純な引数構成では、CSVの列とテストの引数を1対1でそろえる運用が分かりやすくなります。
@CsvFileSource:CSVファイルにテストデータを分ける
CSVファイルとテストクラスを組み合わせる実装例
同じ境界値データを、テスト用のCSVファイルへ移してみます。配置例はsrc/test/resources/ranges/contains-cases.csvです。これは、そのディレクトリをテスト用リソースとしてクラスパスに含めるプロジェクト構成を想定しています。
case_name,value,expected
below-min,9,false
at-min,10,true
above-min,11,true
below-max,19,true
at-max,20,true
above-max,21,falseテストクラスでは、クラスパス上のリソースをresourcesで指定します。冒頭で示したIntRangeと組み合わせる、IntRangeCsvFileSourceTest.javaの例です。
import org.junit.jupiter.params.ParameterizedTest;
import org.junit.jupiter.params.provider.CsvFileSource;

import static org.junit.jupiter.api.Assertions.assertEquals;

class IntRangeCsvFileSourceTest {
    @ParameterizedTest(name = "[{index}] {0}: value={1}, expected={2}")
    @CsvFileSource(
        resources = "/ranges/contains-cases.csv",
        numLinesToSkip = 1,
        encoding = "UTF-8"
    )
    void containsMatchesCsvFile(
            String caseName, int value, boolean expected) {
        IntRange range = new IntRange(10, 20);

        assertEquals(expected, range.contains(value), caseName);
    }
}ここで変わるのはデータの置き場所です。テスト対象とアサーションは@CsvSourceの例と同じなので、外部化したことで期待結果まで変わっていないかを比較できます。
ヘッダー・文字コード・引用符とリソース配置の確認点
この例ではnumLinesToSkip = 1で先頭のヘッダー行を読み飛ばしています。列名を引数名に自動対応させる設定ではないため、データは引き続き左から順に受け取ります。CSVにヘッダーがなければ、この指定によって最初のデータを飛ばしてしまいます。
文字コードは読み込み側でUTF-8を指定し、ファイル側もUTF-8で保存します。日本語のケース名が崩れる場合は、読み込み設定と保存時の文字コードが一致しているかを確認してください。
@CsvFileSourceの既定の引用符はダブルクォートです。@CsvSourceのシングルクォートと混同しないようにします。CSVファイルでは""が空文字、"a,b"がカンマを含む1つの値を表し、引用符のない空欄はnullとして扱われます。値の中のダブルクォートは重ねて表すため、"say ""yes"""はsay "yes"という値です。
リソースが見つからない場合は、ファイルの存在だけでなく、テスト実行時のクラスパスへ含まれているかを確認します。/ranges/contains-cases.csvの先頭のスラッシュはクラスパスのルートを示すもので、OS上の絶対パスを指定しているわけではありません。
外部化による見通しと変更レビューのしやすさを比較する
CSVへ分けると、テストクラスは検証の流れを、CSVはケースの一覧を確認する場所になります。多数の表形式データを追加・修正する場合は、データだけの差分を追いやすくなります。
一方で、CSVだけを見ても対象範囲が10〜20だとは分かりません。レビューではテストコードの固定条件も読む必要があります。複数の範囲を扱うならmin・maxの列を追加するなど、データだけで意味が通じる構成にする余地があります。
少数のケースなら、検証処理の隣に置ける@CsvSourceのほうが確認しやすいこともあります。外部化は件数の多さだけで決めず、列の説明、ケース名、コードとCSVを合わせた差分の読みやすさで判断します。
@MethodSource:オブジェクトや複雑な引数を組み立てる
オブジェクトと期待値を供給する実装例
範囲オブジェクトそのものを入力として渡したい場合は、Javaの供給メソッドでデータを作る@MethodSourceが使えます。次の例では、ケース名、IntRange、判定する値、期待値の4つをまとめて返します。
import java.util.stream.Stream;

import org.junit.jupiter.params.ParameterizedTest;
import org.junit.jupiter.params.provider.Arguments;
import org.junit.jupiter.params.provider.MethodSource;

import static org.junit.jupiter.api.Assertions.assertEquals;

class IntRangeMethodSourceTest {
    @ParameterizedTest(name = "[{index}] {0}: value={2}, expected={3}")
    @MethodSource("provideRangeCases")
    void containsMatchesRangeObject(
            String caseName, IntRange range, int value, boolean expected) {
        assertEquals(expected, range.contains(value), caseName);
    }

    static Stream<Arguments> provideRangeCases() {
        return Stream.of(
            Arguments.of("negative-at-min", new IntRange(-5, -1), -5, true),
            Arguments.of("negative-outside", new IntRange(-5, -1), 0, false),
            Arguments.of("single-point", new IntRange(7, 7), 7, true),
            Arguments.of("single-point-outside", new IntRange(7, 7), 8, false),
            Arguments.of("integer-min",
                new IntRange(Integer.MIN_VALUE, Integer.MAX_VALUE),
                Integer.MIN_VALUE, true),
            Arguments.of("integer-max",
                new IntRange(Integer.MIN_VALUE, Integer.MAX_VALUE),
                Integer.MAX_VALUE, true)
        );
    }
}
単純なmin・maxの組だけならCSVでも表現できます。この例での利点は、供給側でオブジェクトを構築し、テスト側ではその振る舞いを確認できることです。リストや複数の関連オブジェクトを入力にする場合も、この形を応用できます。
供給メソッドの参照とstatic・ライフサイクルの確認点
@MethodSource("provideRangeCases")は、供給メソッド名を指定しています。例では、引数のないメソッドがStream<Arguments>を返し、各Arguments.of(...)が1ケース分の引数に対応します。
テストクラス内の供給メソッドは、通常のライフサイクルではstaticにします。テストクラスに@TestInstance(TestInstance.Lifecycle.PER_CLASS)を指定する場合は、クラス内の非staticな供給メソッドも利用できます。ただし、インスタンスをクラス単位で共有するため、テストが変更するフィールドの扱いには注意が必要です。このアノテーションを使う場合はorg.junit.jupiter.api.TestInstanceをimportします。
別クラスの供給メソッドは、@MethodSource("example.RangeCases#provideRangeCases")のように完全修飾クラス名とメソッド名で参照し、staticにします。まずは例のような引数なしの供給メソッドから始めると、拡張機能による引数解決を考えずに構成できます。
期待値の自動計算や共有状態でテストを複雑にしない
供給メソッドでは自由にJavaを書けますが、その自由度を期待値の計算へ使いすぎないことが大切です。range.contains(value)で求めた結果を期待値として渡すと、対象処理の結果を同じ対象処理と比較するだけになってしまいます。
上の例では、期待値をtrueまたはfalseで明記しています。また、各ケースに新しい範囲オブジェクトを作り、IntRange自体も状態を変更するメソッドを持たない設計にしています。変更可能なリストなどを渡す場合は、ケースごとに別のインスタンスを用意し、前のケースの変更を引き継がないようにします。
現在時刻、乱数、外部サービスの応答に依存するデータ生成も、失敗の再現を難しくします。まずは固定した入力と期待値を列挙し、生成処理を入れる場合は再現条件が分かる構成にしてください。
境界値と異常系を保守しやすいケースに整理する
仕様から入力と期待結果を決め、データソースに落とし込む
データソースが決まっても、必要なテストケースが自動でそろうわけではありません。範囲判定なら、境界を含むか、上下限が同じ範囲を許すか、逆転した範囲をどう扱うかを先に整理します。
| 確認する仕様 | 入力例 | 期待結果 | データのまとめ方 |
|---|---|---|---|
| 下限・上限を含む | 範囲10〜20に対する9・10・11・19・20・21 | 範囲内はtrue、範囲外はfalse | 入力と期待値をCSVの列にする |
| 1点だけの範囲を許す | 範囲7〜7に対する7・8 | 7はtrue、8はfalse | 範囲条件も列に含めるか、オブジェクトで渡す |
| 下限と上限の逆転を拒否する | min=20、max=10 | IllegalArgumentException | 構築時の例外テストとして分ける |
ここで使う「直前」「直後」は整数の隣接値です。日付なら日や秒、金額なら扱う最小単位など、入力の仕様に合わせて距離を決めます。また、Integer.MIN_VALUEの直前やInteger.MAX_VALUEの直後をintの加減算で作ろうとするとオーバーフローするため、型の端に対して機械的に±1を計算しないようにします。
例外を期待するケースと戻り値を確認するケースを分ける
範囲外の値を調べてfalseが返るケースと、不正な範囲の作成で例外が出るケースでは、呼び出す処理と検証方法が異なります。1つのメソッドに条件分岐を足すよりも、テストメソッドを分けると意図が明確になります。
import org.junit.jupiter.params.ParameterizedTest;
import org.junit.jupiter.params.provider.CsvSource;

import static org.junit.jupiter.api.Assertions.assertThrows;

class IntRangeInvalidBoundsTest {
    @ParameterizedTest(name = "[{index}] invalid bounds: min={0}, max={1}")
    @CsvSource({
        "20, 10",
        "1, 0",
        "-1, -5"
    })
    void rejectsReversedBounds(int min, int max) {
        assertThrows(IllegalArgumentException.class,
            () -> new IntRange(min, max));
    }
}不正なIntRangeは、assertThrowsに渡した処理の中で作成しています。供給メソッド内で先に作ると、テスト本体へ到達する前に例外が発生し、意図した例外検証になりません。例外を期待するデータでは、構築済みオブジェクトではなく、構築に使う値を渡すのがポイントです。
ケース数と検証範囲を区別し、まとめすぎを避ける
範囲判定のケースを100件に増やしても、そのテストが画面からの入力やデータベースへの保存まで確認するようになるわけではありません。入力パターンの数と、テストが通る処理の範囲は別の軸です。
同じ前提・実行手順・検証方法を共有できるケースをまとめ、準備やアサーションが大きく変わるケースは分けます。テストの種類ごとの役割は、次の記事で確認できます。
表示名を整え、失敗したケースを読み解く
@ParameterizedTestのnameでケースを識別する
同じメソッドを複数回呼び出すパラメータ化テストでは、メソッド名だけでなく、各ケースの表示名も手掛かりになります。前述の例ではname = "[{index}] {0}: value={1}, expected={2}"を指定しました。
{index}は1から始まる呼び出し番号、{0}・{1}・{2}は0から数えた引数の位置を表します。CSV例では、ケース名、入力値、期待値がそれぞれ対応します。オブジェクトを第2引数に置いたMethodSource例では、入力値は{2}、期待値は{3}へ変わります。
数値を並べるだけより、at-minやabove-maxのような意味のある名前を入れると、失敗した条件を探しやすくなります。インデックスは行の追加や並べ替えで変わるため、それだけをケースの識別に使わないようにします。
表示名の書式にはMessageFormatの規則が関わるため、シングルクォートを装飾のつもりで足すと、プレースホルダーの解釈へ影響する場合があります。まずは例のような単純な書式にし、引用符のエスケープや追加のプレースホルダーは利用バージョンのUser Guideで確認してください。IDEやCI側での見え方も一律ではありません。
期待値の不一致とデータ供給・引数変換の問題を切り分ける
失敗を見たら、まずテスト本体のアサーションまで到達したかを確認します。期待値の不一致と、データを渡す段階での失敗では、調べる場所が異なります。
| 失敗した段階 | 説明用の例 | 最初に確認する場所 |
|---|---|---|
| データ供給 | CSVが見つからない、供給メソッドで例外が出る | リソース配置、メソッド参照、オブジェクトの構築処理 |
| 引数変換・解決 | intの列にtenがある、intへnullを渡している | 該当レコード、列順、引数の型、引用符 |
| テスト対象の実行 | 想定していない例外が対象処理から出る | スタックトレース、入力の前提、対象処理 |
| アサーション | trueを期待したがfalseが返る | 仕様、期待値、対象処理の判定条件 |
たとえば、範囲10〜20に対してvalue=20、expected=true、実際の値がfalseだったとします。まず上限を含む仕様を確認し、データの期待値が正しければ、対象処理がvalue < maxになっていないかを調べます。
一方、CSVの数値列を読み込めない場合は、範囲判定そのものがまだ実行されていない可能性があります。この段階で対象処理の比較演算子を直しても、原因の解消にはつながりません。
CIレポートから入力・期待値・実際の値を確認する
CI上では、失敗したテストクラスとメソッドを特定し、ケース名から該当データを探します。そのうえで、入力、期待値、実際の値、例外の発生箇所を突き合わせます。表示名には実行前に分かる入力と期待値を入れ、実際の値はアサーションの失敗情報から確認する構成です。
レポートの形式によって、表示名が省略されたり、失敗の詳細が別ファイルに保存されたりすることがあります。画面の成功・失敗だけで判断せず、テストレポートやスタックトレースまで確認してください。CSVを使う場合は、ケース番号をファイルの行番号と同一視せず、ケース名で該当レコードを探すと取り違えを避けられます。
再現時には、CIと同じコード・CSVの版を使っているかも確認します。ローカルで期待値を修正した後のデータと、修正前のCI結果を比較すると、原因を読み違えることがあります。
テストを継続的に実行する仕組みについては、次の記事で自動ビルドとテスト自動化の流れを紹介しています。
まとめ
JUnit5のパラメータ化テストは、入力と期待結果を読みやすく並べるために使います。単一入力で同じ期待条件を確認するなら@ValueSource、入力と期待値を表で持つなら@CsvSource、表を外部管理するなら@CsvFileSource、オブジェクトを構築して渡すなら@MethodSourceが候補になります。
データソースを決めたら、境界の包含条件を期待値として明記し、例外を期待するケースは検証方法に合わせて分けます。CSVでは空文字・null・引用符・列と型の対応を確認し、供給メソッドでは期待値の自動計算や変更可能な状態の共有を増やさないようにします。
保守しやすいテストの目安は、ケースを追加する人が「なぜこの入力で、この結果になるのか」を読めることです。意味の分かるケース名と明示的な期待値を持たせ、失敗時にはデータ供給・引数変換・対象処理・アサーションのどこで問題が起きたかを確認しましょう。
コメント